Steam 评论采集项目
本项目必须开启代理,请在学习、开发和运行项目期间保持代理开启。
本课程需要使用 Codex,后续将通过 Codex 提示词逐步完成项目开发。
第二节 数据建模以及存储
分析一条评论需要采集哪些内容
设计数据模型之前,先观察一条实际评论,把页面上的信息逐项拆开。下面以这张 Steam 玩家评测截图为例。
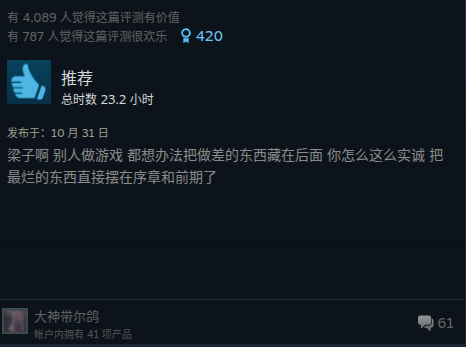
图 1:评测截图。下文中的数字是截图中的值,后续采集时可能发生变化。
评论内容和互动数据
| 需要采集的内容 | 截图中的例子 | 记录时需要注意什么 |
|---|---|---|
| 是否推荐 | 推荐,蓝色大拇指 | 保存推荐或不推荐的状态;图标与文字表达的是同一项信息 |
| 累计游玩时长 | 总时数 23.2 小时 | 记录时长数值和单位,避免将小时误当成分钟 |
| 发布时间 | 10 月 31 日 | 截图只显示月日,完整时间需后续确认,不能猜测年份 |
| 评论正文 | 图中从“梁子啊”开始的整段文字 | 保存完整原文及换行,不用摘要替代正文 |
| 有用票数 | 4,089 人觉得有价值 | 保存为整数 4089,去掉展示用的千位分隔符 |
| 欢乐票数 | 787 人觉得很欢乐 | 保存为整数,与有用票数分开记录 |
| 收到的奖赏数 | 蓝色奖章旁的 420 | 单独记录奖赏数量 |
| 评测下的回复数量 | 右下角气泡旁的 61 | 这是该评测收到的回复数;回复正文需要另行采集 |
截图中的“推荐”状态与正文表达需要分别保存。即使正文带有批评语气,也应如实记录页面上的推荐状态,不能自行改成“不推荐”。
另外,23.2 小时是页面显示的累计时长,不能直接当作作者发表评测时的游玩时长。截图无法说明原始时长的精度,需要精确数值时,应以后续确认的原始数据为准。
作者信息
| 需要采集的内容 | 截图中的位置或例子 | 记录时需要注意什么 |
|---|---|---|
| 作者昵称 | 左下角头像右侧的昵称 | 保存当时显示的昵称;昵称可能重复或变化,不能用它识别唯一作者 |
| 作者头像地址 | 左下角头像 | 取得头像的原始图片地址,供前端展示使用 |
| 账户内拥有的产品数量 | 41 项产品 | 保存为整数;这是产品数量,不能当作作者发布过的评测数量 |
截图之外还需要补充的信息
这些信息需要继续查看页面网址、作者主页或单条评测详情页。本次采集时间则由程序在读取数据时记录,不能从评论的发布时间推算。
| 信息 | 从哪里取得 | 为什么需要 |
|---|---|---|
| 评论唯一编号 | 单条评测的原始数据;下文修改示例的编号为 238805015 |
用于识别同一条评论,避免重复保存 |
| 游戏应用编号 | 目标网址中 /app/ 后面的数字,本例为 4115450 |
确定评论属于哪个游戏 |
| 作者 Steam ID | 数字形式的主页网址,或主页源代码中公开提供的作者资料,下面给出实际例子 | 与昵称分开保存,用于识别作者 |
| 原始评测链接 | 该条评测的详情页链接,下面给出实际例子 | 方便回到 Steam 查看这条评测 |
| 评论语言 | 列表网址的语言筛选参数和页面筛选栏;单条评论仍需按实际数据确认 | 便于按语言筛选评论 |
| 最后修改时间 | 评测详情页上的“更新于 / Updated”标记 | 判断评论是否在发布后更新过 |
| 本次采集时间 | 程序读取数据时的当前时间 | 说明票数、回复数等数据的观察时间 |
1. 游戏应用编号和评论语言:先看列表网址与筛选栏
本项目使用的是 Steam 简体中文评测列表,完整网址:
https://steamcommunity.com/app/4115450/reviews/?browsefilter=toprated&filterLanguage=schinese
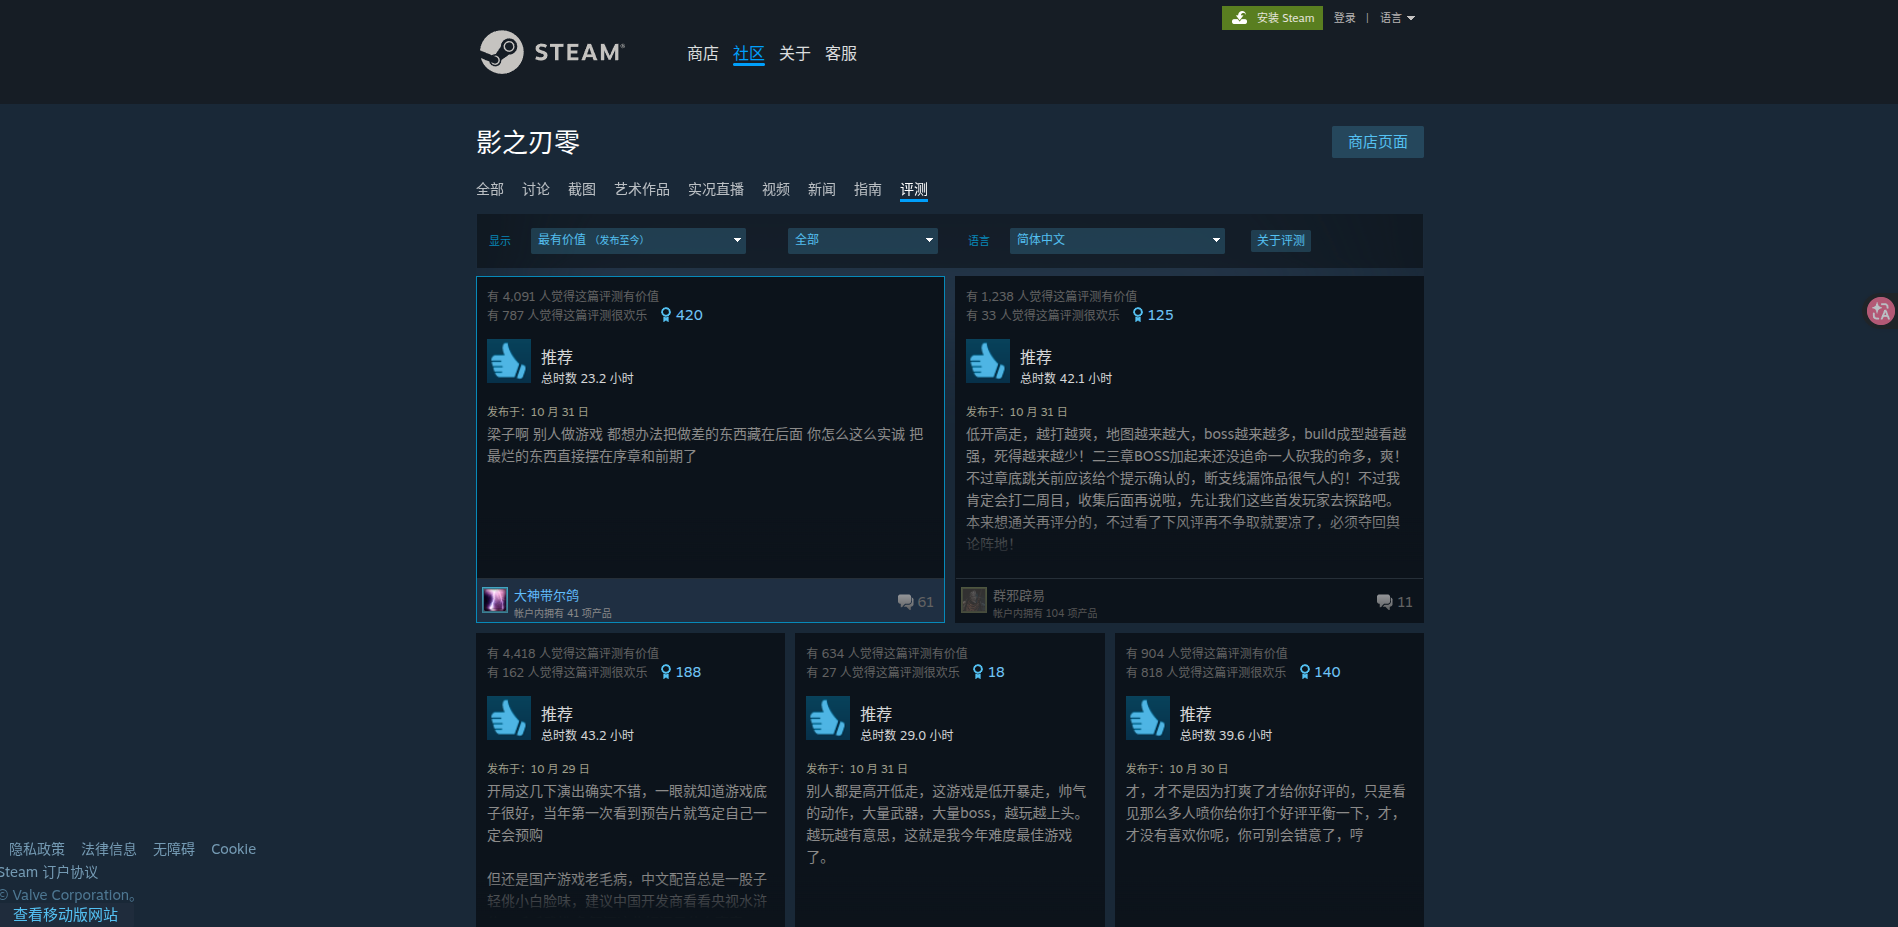
图 2:《影之刃零》的评测列表,页面语言筛选栏显示“简体中文”。
把这个网址拆开看:
| 网址中的部分 | 能确认的信息 |
|---|---|
/app/4115450/reviews/ |
/app/ 后、/reviews/ 前的 4115450 就是本游戏的应用编号 |
filterLanguage=schinese |
当前评测列表筛选的是简体中文,与图中的语言筛选栏相对应 |
因此,应用编号来自目标网址,不需要从评论正文中寻找。schinese 表示这里选择的评论语言条件;页面界面使用中文,并不代表其中所有评论天然都是中文。保存具体评论时,仍要确认该条评论实际所属的语言。
2. 作者 Steam ID 和原始评测链接:查看单条评测
以图 2 左上角“大神带尔鸽”发布的评测为例,页面中的实际链接是:
作者的 Steam 主页完整网址:
https://steamcommunity.com/profiles/76561198091930150/
网址中 /profiles/ 后面的 76561198091930150 是这位作者的 Steam ID。
这条评测的原始详情页完整网址(简体中文界面):
https://steamcommunity.com/profiles/76561198091930150/recommended/4115450/?l=schinese
这个链接指向该作者对应用 4115450 发布的评测,可用于回到原文。
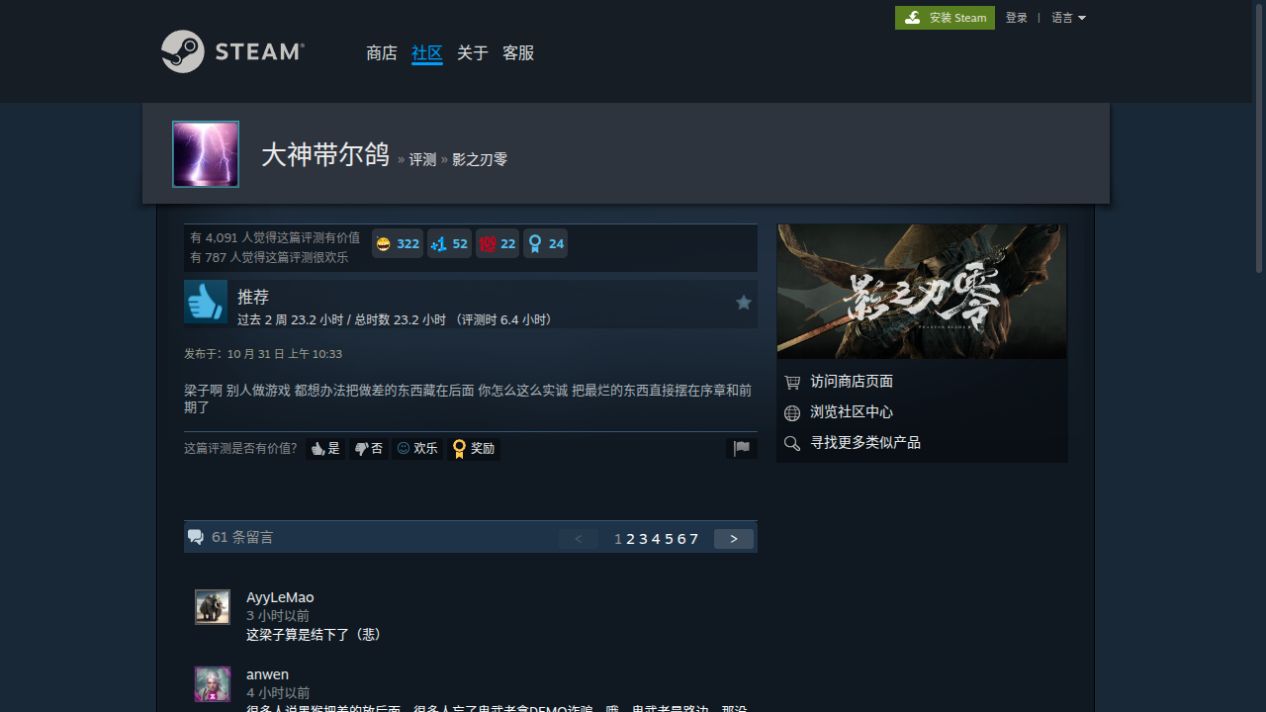
图 3:原始评测详情页,与上面的作者和游戏编号相对应。
这两个数字不能混淆:76561198091930150 标识作者,4115450 标识游戏。作者昵称另行保存,不能拿昵称代替 Steam ID。
如果作者的主页使用 /id/自定义名称/ 这样的地址,就需要进一步取得数字 Steam ID。例如,同一游戏的评测作者 UpWeGoOoOo 使用的主页完整网址是:
https://steamcommunity.com/id/UpWeGoOoOo/
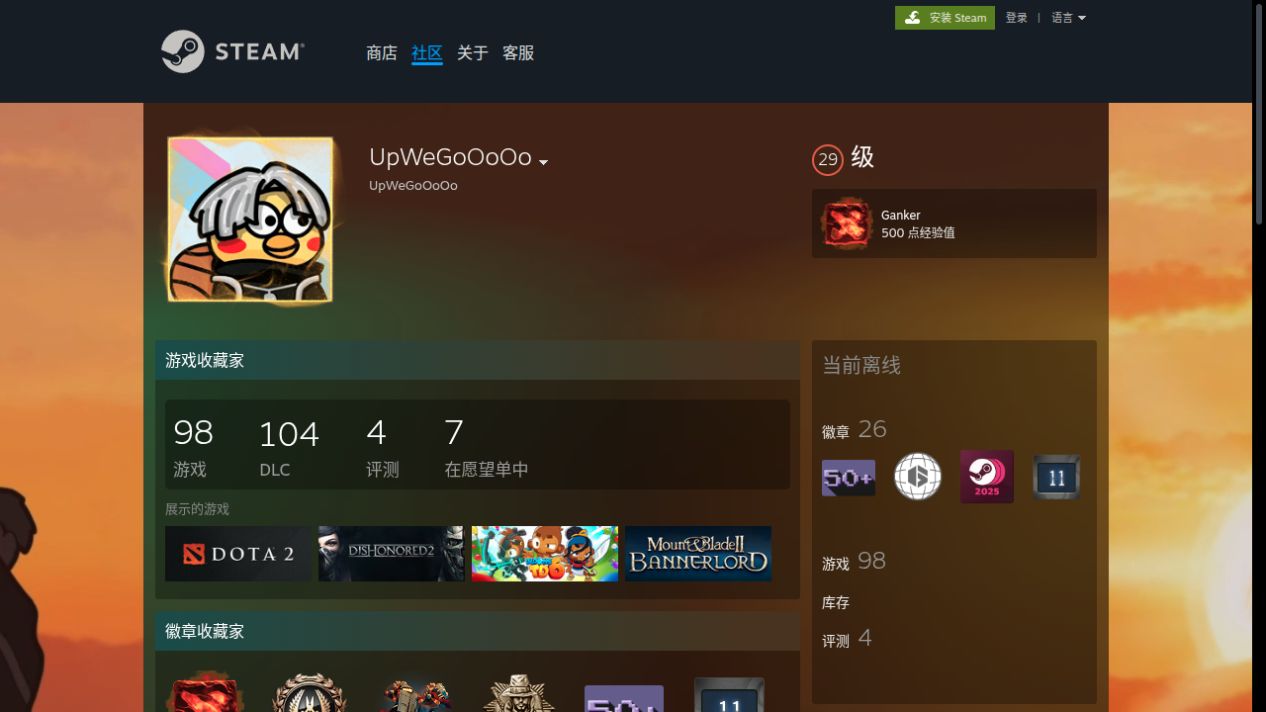
图 4:自定义地址主页示例。网址中的 UpWeGoOoOo 是自定义地址名称,不能直接作为数字 Steam ID。
可以按下面的方法查看这位作者的实际编号:
- 用 Chrome 或 Edge 打开上面的主页网址,按
Ctrl+U查看网页源代码。 - 按
Ctrl+F搜索g_rgProfileData,定位 Steam 随主页提供的作者资料。 - 在这段资料中确认作者显示名称,并读取对应的
steamid。本次查看到的两项信息如下(节选):
"personaname": "UpWeGoOoOo"
"steamid": "76561198166165485"
因此,这位作者的数字 Steam ID 是 76561198166165485,数字形式的主页完整网址为:
https://steamcommunity.com/profiles/76561198166165485/
本次访问数字网址后,Steam 自动跳回了前面的自定义地址,显示的仍是同一位作者。这个编号是从 Steam 提供的资料中读取的,并不是把 UpWeGoOoOo 转换或推算成数字。保存数据时,应使用数字 Steam ID 识别作者,并保留实际主页链接供回看。
读到这里,你可能会好奇,我们怎么知道要按 Ctrl+F 搜索 g_rgProfileData,进而找到 steamid。寻找数据的真实来源,正是爬虫开发的难点之一。在 AI 工具普及之前,这类工作更依赖工程师对数据的敏感度和分析经验,需要仔细查找和核对隐藏在网页源码中的信息。
现在,我们可以把这些查找工作交给 Codex 协助完成。在构思数据存储的阶段,就可以根据准备保存的信息,让 Codex 提前调查数据来源、确认能否获取,为后续编写爬虫逻辑做好准备。
3. 最后修改时间:看详情页的更新标记
一个实际修改过的例子是作者 e^ix=cosx+isinx 发布的评测,完整网址(简体中文界面):
https://steamcommunity.com/profiles/76561199102670623/recommended/4115450/?l=schinese
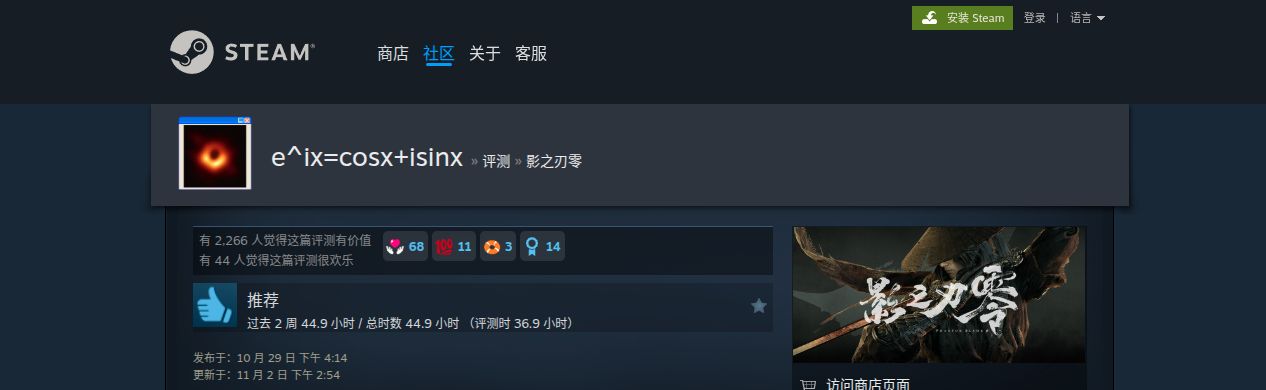
图 5:同一条评测的发布时间和最后修改时间,以截图时页面的显示为准。
页面同时显示了下面两项时间:
| 页面上的标记 | 访问时显示的内容 | 表示什么 |
|---|---|---|
| 发布于(Posted) | 10 月 29 日 下午 4:14 | 这条评测最初发布的时间 |
| 更新于(Updated) | 11 月 2 日 下午 2:54 | 页面记录的最后修改时间 |
时间表与图 5 保持一致。页面时间可能随浏览器的时区设置变化,不能把不同显示时区下的时间直接混用。这里不自行补充页面未写出的年份或时区;后续保存完整时间时,再读取原始时间记录并统一时区。
这条评测当前正文中还有“2026年11月1日追评”的文字,但确定最后修改时间,应以页面的 Updated 标记为依据,不能用作者自己写在正文中的日期替代。
这个例子说明,同一条评测的发布时间和最后修改时间可能不同,应分别记录。本例没有取得修改前的正文,因此只能确认评测更新过,不能还原每次修改的具体内容。
评论编号和作者编号建议作为文本保存,它们用于识别数据,不参与数值计算。票数、回复数和产品数量按整数记录,游玩时长应保留对应单位。
采集范围需要区分清楚
- 评测正文与评测下的回复是两种内容。 本图展示了一条玩家评测和它的回复数量,并没有展示那 61 条回复的正文。
- 发布时间、修改时间和采集时间各有用途。 前两项描述评测本身,采集时间描述我们获取这份数据的时刻。
- 未取得数据与数值为零应分别记录。 昵称、头像、奖赏数或产品数量没有取到时,应标记为缺失,不能随意填成
0。 - 截图样例值不应写死在程序中。
4089、787、420和61都需要在实际采集时读取,并保留对应的采集时间。
确定这些信息后,再根据实际选定的采集范围设计 Python 数据模型和 SQLite3 数据表。
使用 Codex 提示词建立实体类
先理解实体类的作用
前面已经列出了需要采集的信息。接下来,要把这些信息组织成 Python 能使用的对象。本教程把表示作者、评测这类业务对象的类称为实体类。
想象我们要给 Steam 评测整理纸质档案,先印两种空白卡片:一张记录作者,一张记录评测。空白卡片规定有哪些栏目,相当于“类”;填入具体数据的一张卡片,相当于“对象”,也叫“实例”。
例如,“作者卡要有编号和昵称”是在规定卡片的格式;“编号是 76561198091930150,昵称是大神带尔鸽”则是一张已经填好的作者卡。前者说明怎么组织数据,后者装着一位具体作者的数据。
本节建立两个类:
| 实体类 | 表示什么 | 用什么识别 |
|---|---|---|
Author |
一位评测作者 | 作者的数字 Steam ID |
Review |
一条玩家评测 | 评论唯一编号 |
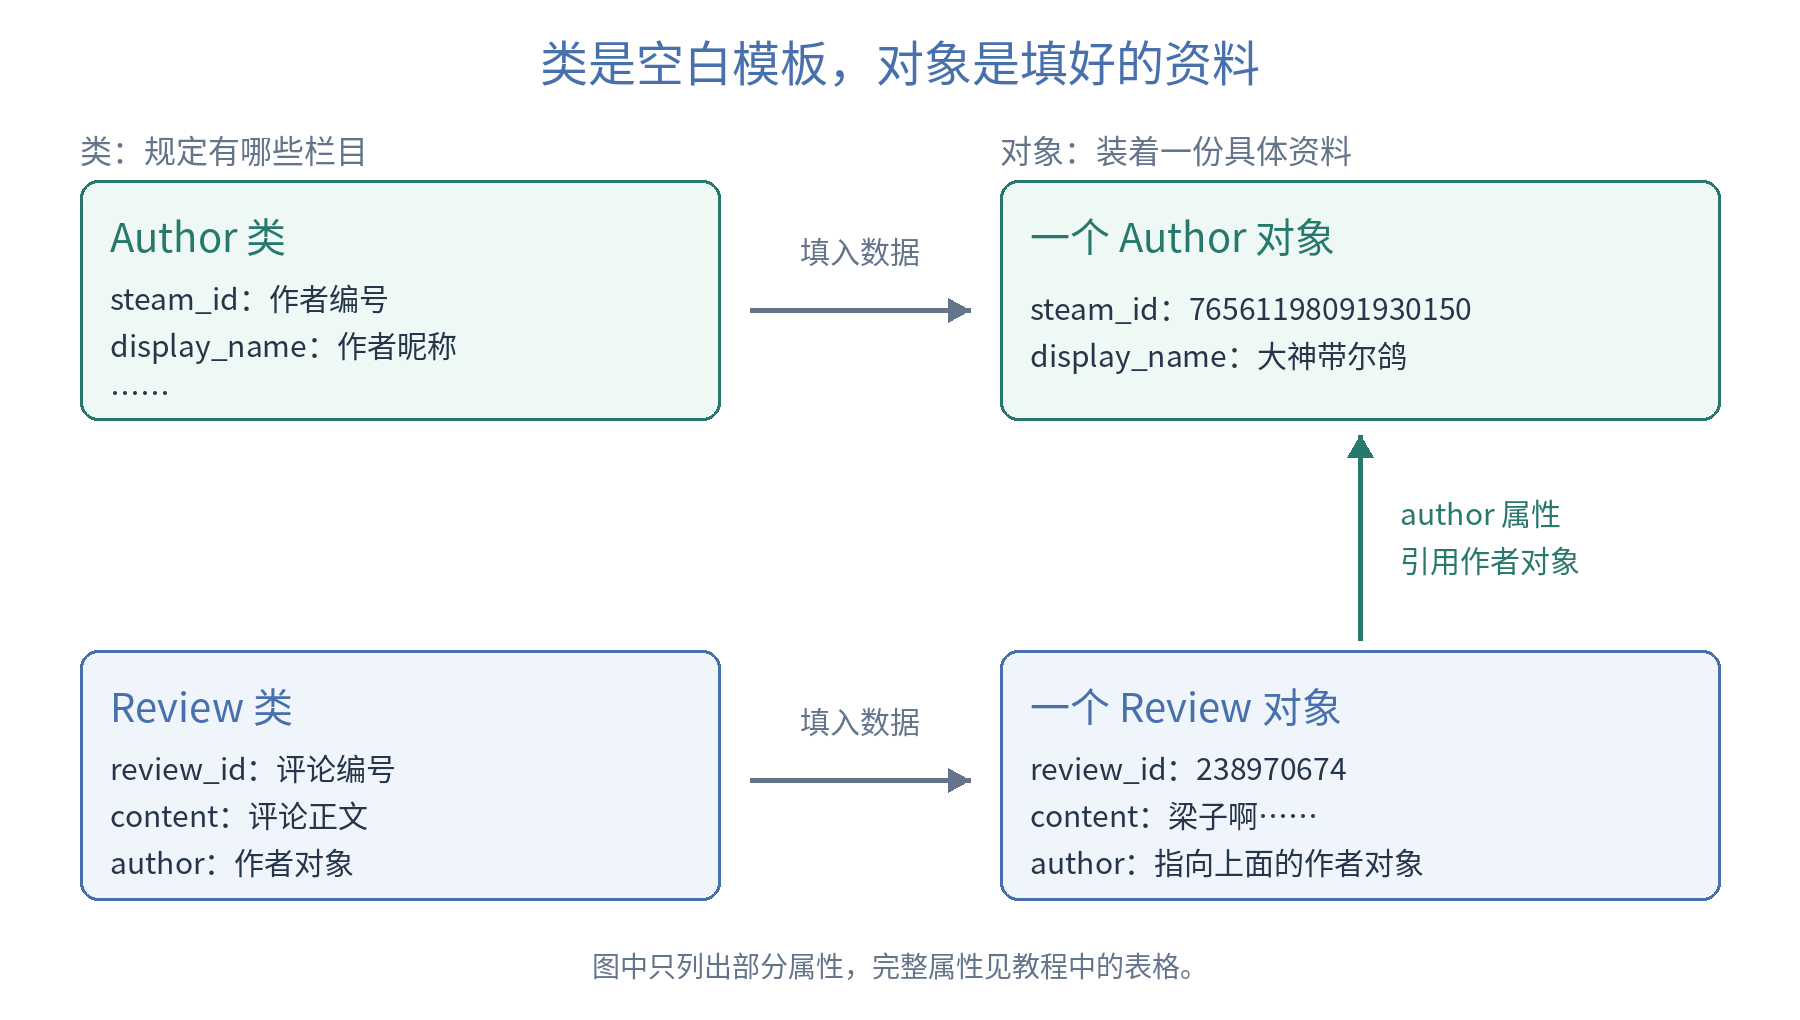
图 6:左侧是规定格式的类,右侧是填入具体数据的对象。图中只展示部分属性。
按图 6 从左往右看:
Author类规定作者资料怎么填,填入“大神带尔鸽”的数据后,得到一个具体的Author对象。Review类规定评测资料怎么填,填入评测编号、正文等数据后,得到一个具体的Review对象。- 评测卡还有一个
author栏目。顺着它指向的作者卡,就能知道这条评测是谁写的。
这里的“指向”在代码中叫引用,可以先理解成“顺着这个属性,能找到另一个对象”。Review 的 author 属性保存的是一个 Author 对象的引用。两个类各自定义一种资料,通过这个属性关联起来。
假设手里这张评测卡在程序中叫 review,下面三种写法就很好理解了:
| 写法 | 用大白话解释 |
|---|---|
review.content |
打开这张评测卡,读它的正文 |
review.author |
顺着评测卡上的作者栏目,找到对应的作者卡 |
review.author.display_name |
找到作者卡后,再读上面的昵称 |
所以,review.author.display_name 可以一段一段读成:“这条评测 → 它的作者 → 作者的昵称”。这种写法正好对应我们理解一条评测的过程。
用档案室理解各自的职责
再把整个采集过程想成一间档案室:有收集资料的人,有填好的资料卡,还有负责入库的人。
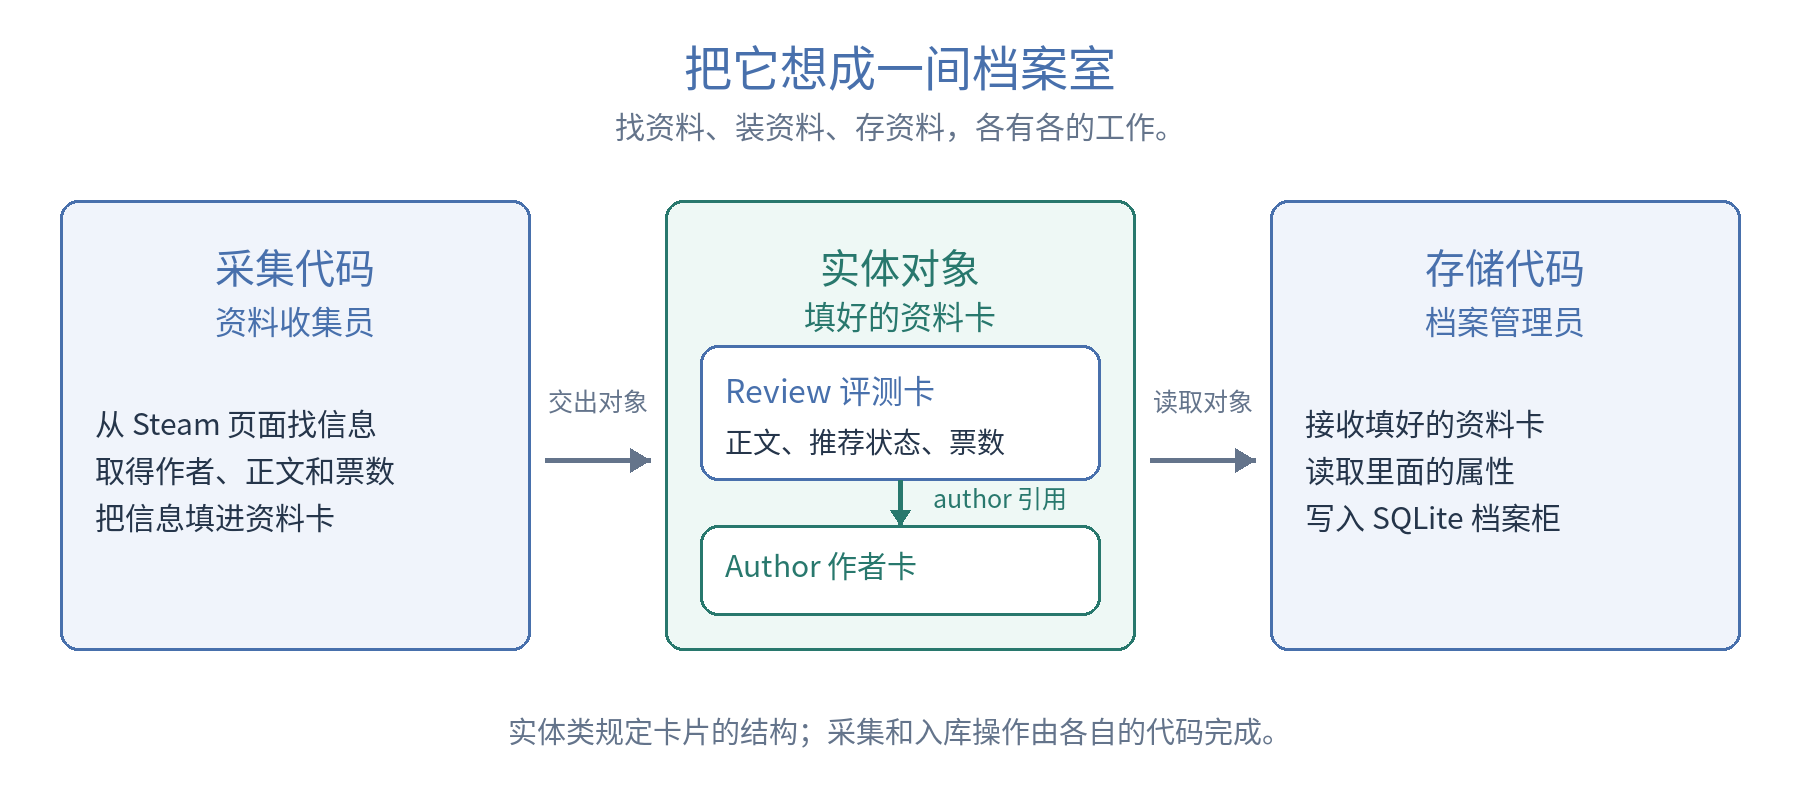
图 7:实体对象在采集与存储之间传递数据。采集和存储代码将在后续步骤编写。
- 采集代码像资料收集员。 它到 Steam 网页中找作者、正文和票数,把取得的信息填进
Author和Review对象。 - 实体对象像填好的资料卡。 它按约定的格式装着信息,让后面的代码知道每项数据是什么。
- 存储代码像档案管理员。 它接收资料卡,读取里面的属性,再把数据保存进 SQLite3 这个“档案柜”。
卡片负责装资料,收集员负责找资料,管理员负责存资料。对应到代码中,就是实体类表达数据,采集代码取得数据,存储代码保存数据。以后调整网页读取方式时,先看采集代码;调整入库方式时,先看存储代码。这就是把不同职责分开的实际用处。
实体类与数据库表也需要分别设计:建立 Python 类,并不会自动创建数据库表。
使用 dataclass 减少重复代码
本节使用 Python 标准库的 dataclass 定义这两个类。我们声明属性及其类型后,dataclass 可以自动生成初始化方法,便于用参数创建对象,减少重复的赋值代码。
沿用资料卡的比喻:你告诉 dataclass 卡片有哪些栏目,它帮你准备好“填卡入口”,也就是初始化方法。创建对象时传入具体的数据,就相当于填好一张卡。
Python 官方说明的完整网址:
https://docs.python.org/3/library/dataclasses.html
下面把前面分析的信息命名为本项目的 Python 属性。这里的名称用于组织我们自己的代码,后续再把实际取得的数据对应到这些属性上。
Author:作者信息
| 属性名 | Python 类型 | 含义与默认值 |
|---|---|---|
steam_id |
str |
数字 Steam ID,以文本保存,创建对象时必须提供 |
display_name |
Optional[str] |
作者显示昵称,未取得时为 None |
profile_url |
Optional[str] |
作者主页的实际链接,未取得时为 None |
avatar_url |
Optional[str] |
作者头像地址,未取得时为 None |
products_owned |
Optional[int] |
账户拥有的产品数量,未取得时为 None |
Review:评测信息
| 属性名 | Python 类型 | 含义与默认值 |
|---|---|---|
review_id |
str |
评论唯一编号,必须提供 |
app_id |
int |
游戏应用编号,必须提供 |
author |
Author |
这条评测对应的作者对象,必须提供 |
content |
str |
评测完整正文,必须提供 |
is_recommended |
bool |
是否推荐,必须提供真实状态 |
language |
str |
评测语言,必须提供 |
review_url |
str |
原始评测链接,必须提供 |
published_at |
int |
发布时间,使用秒级 Unix 时间戳,必须提供 |
collected_at |
int |
本次采集时间,使用秒级 Unix 时间戳,必须提供 |
playtime_minutes |
Optional[int] |
累计游玩分钟数,未取得精确数值时为 None |
updated_at |
Optional[int] |
最后修改时间,使用秒级 Unix 时间戳,未取得时为 None |
helpful_votes |
Optional[int] |
有用票数,未取得时为 None |
funny_votes |
Optional[int] |
欢乐票数,未取得时为 None |
awards_count |
Optional[int] |
收到的奖赏数,未取得时为 None |
reply_count |
Optional[int] |
评测下的回复数量,未取得时为 None |
str 表示文本,int 表示整数,bool 表示真假状态。
str 与 Optional[str] 有什么区别?
str 说明这里预期填写字符串,例如作者昵称 "大神带尔鸽"。Optional[str] 说明这里既可以填写字符串,也可以填写 None,本项目用 None 表示暂时没有取得这项数据。Optional 来自 Python 标准库 typing。
你可以把它们理解成资料卡的填写规则:str 要求这一栏填文字,Optional[str] 允许这一栏暂时留空。这里的“留空”用 None 表达;空字符串 "" 仍然是一段文本值,与 None 不同。
还要分清“允许填什么”与“能否省略不填”。在 dataclass 中,下面三种写法的含义不同:
| 属性写法 | 按类型约定允许的值 | 创建对象时能否省略这个参数 |
|---|---|---|
display_name: str |
字符串,例如 "大神带尔鸽" |
不能,没有设置默认值 |
display_name: Optional[str] |
字符串或 None |
不能,仍然没有设置默认值;未知时需要明确传入 None |
display_name: Optional[str] = None |
字符串或 None |
可以,省略后使用默认值 None |
因此,Optional[str] 表示允许值为 None,= None 才是设置默认值。本项目的作者昵称采用第三种写法:取得昵称时传入文字,没有取得时可以省略,由默认值记录为 None。作者的 steam_id 使用 str 且没有默认值,创建作者对象时必须提供这个编号。
同理,Optional[int] 表示整数或 None。本项目再为这些属性设置默认值 None,就允许创建对象时暂不提供对应数据。
例如,回复数为 0 表示确实没有回复,回复数为 None 表示当前没有取得这个数据。可以把 None 理解成“卡片上这一栏还空着”,而 0 是查过之后明确填上的数值,两者不能混用。同样,没有取得修改时间,也不等于已经确认评测从未修改。
类型标注用于说明预期的数据类型,并不会自动校验抓取结果。后续接入采集数据时,仍需检查必填信息、数值范围和时间单位。类型标注的官方说明完整网址:
https://docs.python.org/3/library/typing.html
按轮次发送提示词
教程供你在项目之外单独阅读。操作时,将下面对应轮次的完整提示词复制到 Codex 的项目聊天中。提示词已经包含本轮需要的属性要求,Codex 根据聊天中的要求和项目实际文件开展工作。
本节约定把两个实体类分别保存在 backend/entities/author.py 和 backend/entities/review.py。下面是完成后的目录示意,文件将通过后续提示词逐个创建。
SteamScraper/
└── backend/
    └── entities/
        ├── author.py
        └── review.py
继续遵守第一节的协作规则:项目使用 conda 的 common 环境;每轮只创建或修改一个文件,新增和修改的代码总量不超过 20 行;未经开发者明确要求,不自行运行测试。
每条提示词单独发送,读完 Codex 的回复后,再进入下一步。
第一轮:先确认实体设计,暂不写文件
先读取项目根目录的 AGENTS.md,并查看项目现有目录。
本次根据以下要求建立 Author 和 Review 两个实体类,使用标准库 dataclass。
Author 保存作者信息;Review 保存评测信息,并通过 author 属性引用一个 Author 对象。
Author 的必填属性为 steam_id: str;可缺失属性为 display_name、profile_url、avatar_url(均为 Optional[str])和 products_owned(Optional[int]),这四项默认 None。
Review 的九个必填属性为 review_id: str、app_id: int、author: Author、content: str、is_recommended: bool、language: str、review_url: str、published_at: int、collected_at: int。
Review 的六个可缺失属性为 playtime_minutes、updated_at、helpful_votes、funny_votes、awards_count、reply_count,均为 Optional[int],默认 None。
时间属性 published_at、collected_at、updated_at 使用秒级 Unix 时间戳,playtime_minutes 使用分钟;未知值用 None,与已确认的 0 区分。
实体类只保存数据,不包含网页请求、数据转换或数据库操作,也不把具体作者或评测的数据写成默认值。
计划分别保存到 backend/entities/author.py 和 backend/entities/review.py;如果已有同等职责的类或目录,先说明情况。
请用新手能理解的话复述两个类的职责、属性、必填项和默认值,并说明它们的包含关系。
如果你认为有更合适的组织方式,先说明原因和影响,由我决定是否调整。
本轮只说明设计,不修改文件、不运行项目或测试、不安装依赖,等待我确认。
先核对 Codex 是否保留了前面确定的信息,是否区分了未知值与零,以及是否把网页请求或数据库操作混进实体类。确认后,再发送下一条。
第二轮:创建 Author
先读取项目根目录的 AGENTS.md,并回顾当前聊天中上一轮确认的实体设计。
本轮只创建或修改 backend/entities/author.py,生成或修改的代码总量不超过 20 行。
使用标准库 dataclass 定义 Author,使用 typing.Optional 表示允许缺失的值。
steam_id 为 str,必须提供;display_name、profile_url、avatar_url 为 Optional[str],products_owned 为 Optional[int],这四项默认 None。
必填属性写在带默认值的属性之前;不要把具体作者的数据写成默认值。
本类只保存数据,不发起网页请求、不连接数据库,不额外添加其他类或功能。
不运行项目、不运行测试、不安装依赖、不修改其他文件。
完成后解释每个属性,以及 dataclass 如何帮助创建作者对象,然后停止。
第三轮:创建 Review 的必填部分
先读取项目根目录的 AGENTS.md 和已有的 backend/entities/author.py,按下面的属性要求创建 Review。
本轮只创建或修改 backend/entities/review.py,生成或修改的代码总量不超过 20 行。
使用标准库 dataclass 定义 Review,并按同级文件的模块位置导入 Author。
本轮只声明九个必填属性:review_id: str、app_id: int、author: Author、content: str、is_recommended: bool、language: str、review_url: str、published_at: int、collected_at: int。
published_at 和 collected_at 的约定单位为秒级 Unix 时间戳,不在实体类中猜测年份或转换页面日期。
author 保存 Author 对象,不重复声明作者昵称、头像等属性。
不添加网页请求、数据库操作或其他功能;不运行项目或测试,不安装依赖,不修改其他文件。
如果超过 20 行,先停下说明剩余工作,不压缩代码绕过限制。
完成后解释为什么一条评测要引用一个作者对象,然后停止。
这一轮先完成必填部分,下一轮再补充允许缺失的属性。这样可以保持每次改动较小,方便阅读。
第四轮:补齐 Review 的可缺失属性
先读取 AGENTS.md 和已有的两个实体类。
本轮只修改 backend/entities/review.py,生成或修改的代码总量不超过 20 行。
保留现有九个必填属性,在其后补充 playtime_minutes、updated_at、helpful_votes、funny_votes、awards_count、reply_count。
这六项都使用 Optional[int],默认值均为 None,并补充所需的标准库导入。
累计游玩时长的单位为分钟,updated_at 的单位为秒级 Unix 时间戳;未知值不能默认写成 0。
不添加采集、数据转换或数据库功能,不修改其他文件,不运行项目或测试。
完成后解释 None 与 0 的区别,并用自然语言说明创建 Author、Review 对象时分别需要提供什么,然后停止。
完成后,你应能读懂两个类的属性,并说清楚一条评测如何关联作者。此时完成的是实体类定义;数据的获取、校验和入库将在后续步骤分别处理。尚未执行验证时,只能说明代码已编写,不能声称运行已经通过。